로컬 LLM 장비는 먼저 모델이 메모리에 들어가는지 보고, 그다음 대역폭을 본다. RTX 4090 24GB가 있어서 DGX Spark 128GB는 구매 검토 단계까지만 가고 아직 사지 않았다.
DGX Spark는 보유한 적이 없어서 공식 사양으로만 비교한다. 맥미니 M6 32GB는 2026년 9월 말에 샀고 LLM은 보조 실험 수준이다. 직접 측정한 값은 4090 쪽에만 있다. 맥미니를 개발용으로 쓴 이야기는 별도 글에 정리했다.
로컬 LLM에서 용량은 왜 입장권인가
모델 가중치에 context(KV cache)를 더한 크기가 쓸 수 있는 메모리 안에 들어가야 한다. 안 들어가서 RAM으로 넘어가면 실행은 돼도 매일 쓸 속도는 아니었다.
4090에서 Qwen3-Coder 30B(MoE, Q4 계열 약 17GB)를 LM Studio로 돌려 봤다. 2026년 9월 기록이다. 24GB에서 이 모델은 32K context까지 안정적이고 64K부터 여유가 없다. Q4에 32K context면 VRAM이 약 21.1GB, 64K는 약 23.4GB였고, 128K는 GPU를 넘어 RAM으로 밀려 나갔다.
체감 차이는 Cline으로 프로젝트 전체를 읽힐 때 났다. 같은 모델을 쓰던 환경에서 context 설정을 128K에서 32K로 낮춘 뒤 첫 응답 시간이 10초 이상에서 약 2.8초로 줄었다. 다만 prompt와 cache 상태까지 통제한 벤치마크는 아니어서 context 크기만의 효과라고 단정하지 않는다. 그래도 최대 context를 크게 잡는 것도 체감 latency가 나빠질 수 있다는 건 알게 됐고, 지금은 필요한 크기로만 설정한다.
처음에는 이걸 낙관적으로 봤다. VRAM이 모자라면 64GB RAM으로 offload하면 되니 어쨌든 돌아간다고 생각했다. 실제로 돌아가긴 했다. 다만 첫 token을 기다리는 시간과 생성 속도 저하가 바로 느껴졌다. 그때 실행 가능과 사용 가능이 다른 말이라는 걸 배웠다.
양자화한 70B급을 GPU와 RAM에 나눠 올려 본 적도 있다. 메모리에 넣는 것 자체는 재미있었지만, 대화형 코딩이나 채팅에 기다림 없이 쓴다는 기준에서는 4090 24GB의 장점이 크게 줄었다.
그래서 "24GB에 64GB RAM을 더하면 88GB"라는 계산은 하지 않는다. 어느 정도가 VRAM 안에 상주하는지를 같이 본다.
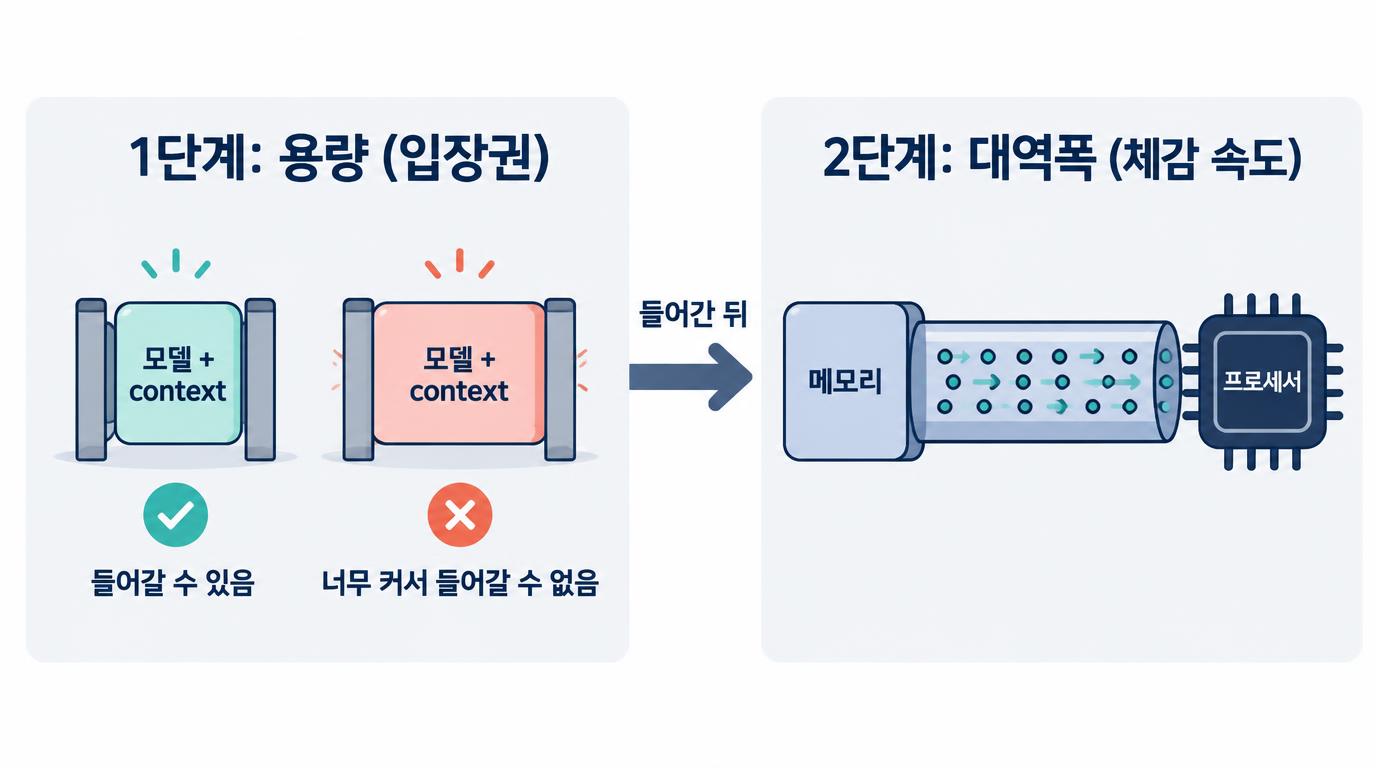
대역폭은 들어간 뒤의 체감 속도를 어떻게 정하나
토큰을 하나 만들 때마다 활성 가중치를 메모리에서 읽기 때문에, 들어간 뒤의 생성(decode) 속도는 용량보다 대역폭에 크게 좌우되고, 긴 입력을 처리하는 prefill은 연산 성능의 영향이 크다. DGX Spark는 128GB여도 273GB/s다.
| 장비 | 메모리 | 대역폭 | 내 사용 경험 |
|---|---|---|---|
| RTX 4090 | 24GB GDDR6X | 약 1TB/s급 | 직접 사용·VRAM 실측 |
| 맥미니 M6 | 32GB 통합 메모리 | 170GB/s | 보조 실험 수준 |
| DGX Spark | 128GB LPDDR5x 통합 메모리 | 273GB/s | 미보유, 공식 사양만 |
숫자를 놓고 보면 4090은 용량이 가장 작고 대역폭이 가장 크다. Spark는 반대다.
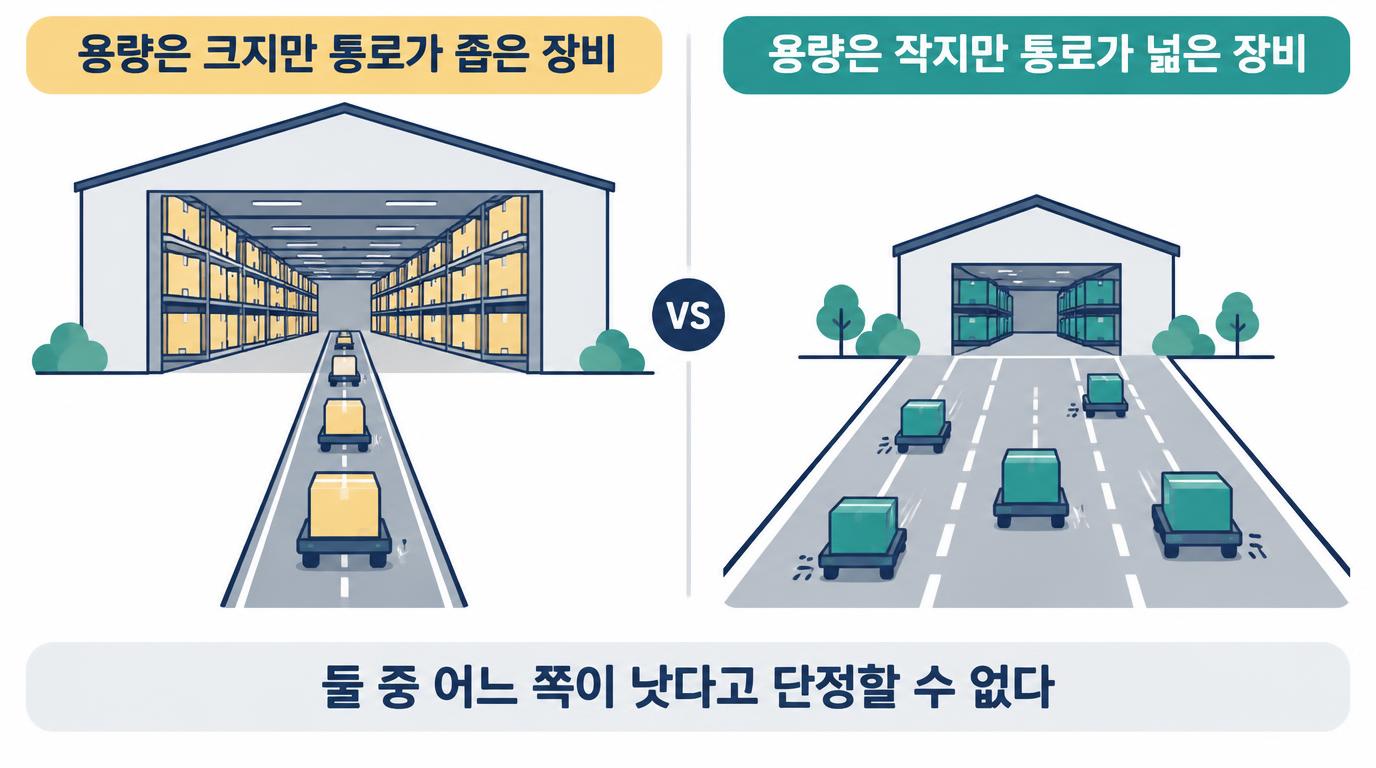
128GB가 무조건 4090보다 좋다고 보지 않는다. 4090이 빠르다는 이유로 용량 문제가 사라지지도 않는다. 4090에 안 들어가는 모델이면 높은 대역폭도 전체를 GPU에 올리지 못한다는 문제를 풀어 주지 못한다.
나도 한 번 틀렸다. Apple 통합 메모리는 GPU와 CPU가 메모리를 같이 쓰니 VRAM 경계가 덜 답답하다. 그 점은 좋았다. 하지만 용량만 보고 NVIDIA 외장 GPU와 속도를 같은 선에 놓으면 안 됐다. M6의 170GB/s를 확인한 뒤로는 "32GB니까 로컬 AI도 꽤 빠르겠지"라는 판단을 더 경계한다.
내 장비를 어떤 순서로 읽는가
내 기준은 네 단계다. 실사용 가능한 메모리에 들어가는가, 대역폭과 연산 성능, 실행 도구 가속, 가격·전력·소음 순으로 본다.
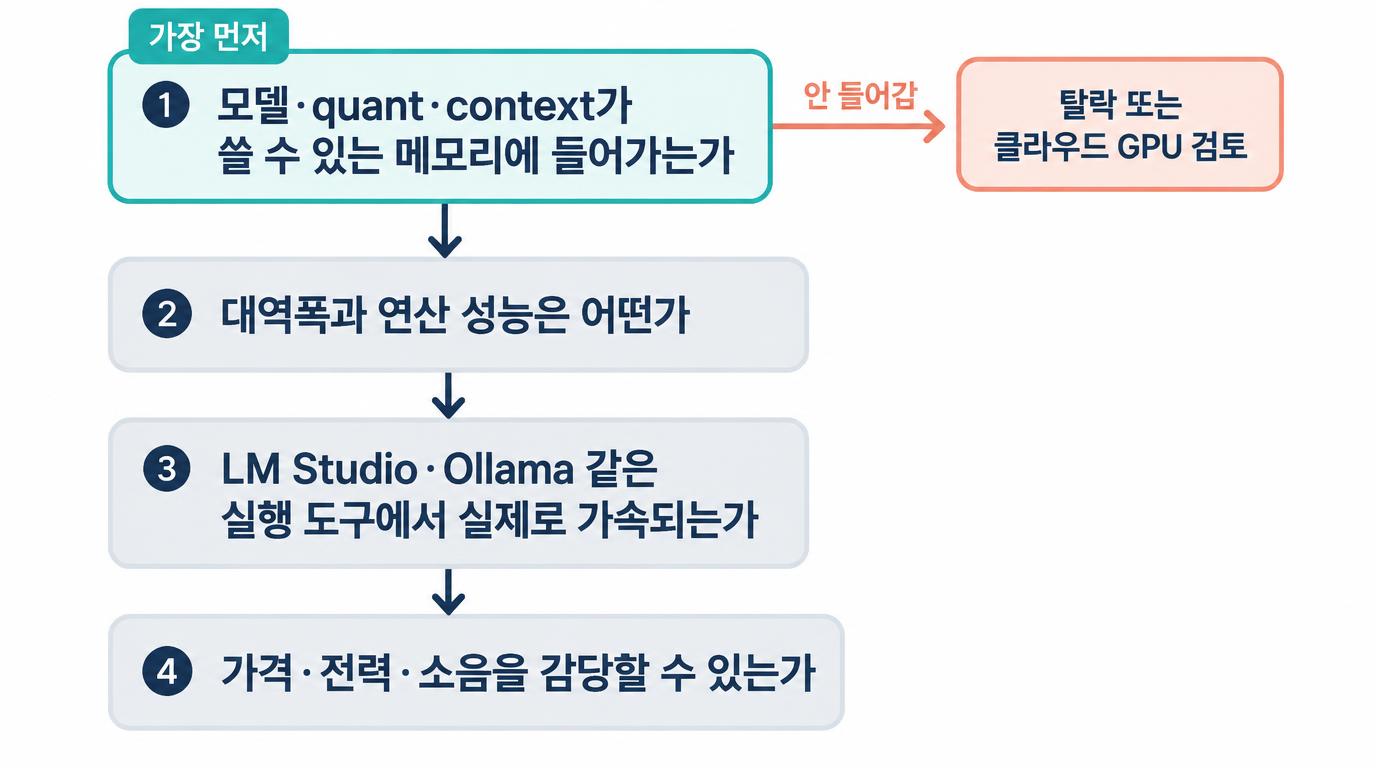
- 원하는 모델과 quant, context가 쓸 수 있는 메모리에 들어가는가
- 들어간다면 대역폭과 연산 성능은 어떤가
- LM Studio·Ollama 같은 실행 도구에서 실제로 가속되는가
- 가격·전력·소음을 감당할 수 있는가
사양표는 GPU 이름이 아니라 실제로 쓸 수 있는 메모리부터 읽는다. 용량 때문에 탈락시킨 경험도 있다. 4090보다 연산 성능만 조금 좋아지고 VRAM이 사용 범위를 크게 넓혀 주지 않는 업그레이드는 매력이 낮았다. GPU를 바꾼다면 연산 성능 몇 %보다 VRAM 등급이 달라지는지를 먼저 본다.
세 장비는 서로를 대체하지 않는다.
- 4090 워크스테이션: 24GB 안에 들어가는 모델을 빠르게 돌리는 CUDA 머신이다. 전력·발열·소음·공간 비용이 따라온다.
- 맥미니 M6: 책상 위에서 조용하다. 맡는 일은 개발, agent workflow, 가벼운 로컬 AI다. 32GB 안에서 작은~중간 양자화 모델은 통합 메모리 덕에 편했고, 큰 모델을 시도할수록 여유가 빨리 줄었다. 4090 대체용으로 산 게 아니다.
DGX Spark는 그 중간이다. 4090보다 훨씬 큰 메모리이면서 워크스테이션보다 작은 장비라는 점이 끌렸다. 4090을 쓰며 VRAM만 조금 더 있었으면 하는 순간을 겪었기 때문이다. 공식 사양과 가격대, 후기를 찾아보는 데까지 갔지만 조사할수록 273GB/s도 같이 보였다.
문제를 "70B급을 로컬에 올릴 수 있느냐"로 정의하면 Spark가 매력적이다. "매일 쓰는 20~30B급 모델을 최대한 빠르게"로 정의하면 이미 가진 4090의 가치가 여전히 크다. 그래서 아직 사지 않았다.
사기 전에 이미 가진 GPU와 cloud GPU부터 보는 이유
매일 쓰는 모델이 24GB 안에 들어가면 가진 GPU를 쓰고, 가끔 70B 이상이면 cloud GPU를 먼저 검토한다. 큰 모델을 매일 쓰고 데이터도 로컬이어야 할 때 고용량 장비를 산다.
- 매일 반복해서 쓰고 작은 모델로 충분하다: 이미 가진 GPU를 최대한 쓴다.
- 가끔 70B 이상이 필요하다: 새 장비 전에 cloud GPU부터 본다.
- 큰 모델을 매일 쓰고 데이터도 로컬에 있어야 한다: 고용량 장비를 산다.
Spark 같은 장비는 128GB를 갖고 싶은지가 아니라, 128GB가 필요한 작업을 일주일에 몇 시간 실제로 돌리는지로 정한다.
손익분기는 거칠게 시작한다. 장비 실구매가를 쓸 cloud GPU의 시간당 비용으로 나눠 손익분기 시간을 먼저 구하고, 전기료·감가·대기 시간·데이터 이동·언제든 쓸 수 있는 편의성을 얹는다.
2026년 10월 기준, 바뀔 수 있는 부분
가격과 구성은 계속 바뀌므로 구매 직전에 NVIDIA 공식 페이지를 다시 확인해야 한다. 이 절은 2026년 10월 11일 기준으로 점검했다.
- DGX Spark는 128GB 구성 외에 64GB 구성이 10월 2일 발표됐다. 64GB는 10월 23일부터 Acer·ASUS·Dell·Gigabyte·HP·MSI 같은 파트너사에서만 판매된다고 NVIDIA는 밝혔다. 이 글의 비교는 128GB 구성 기준이고, NVIDIA 공식 제품 페이지에는 128GB 구성의 가격 표시가 없었다.
- RTX Spark는 DGX Spark와 다른 Windows PC용 제품이다. NVIDIA는 이 제품을 탑재한 PC가 10월에 나온다고 밝혔지만 구체적인 출시일과 사양은 이 글에서 다루지 않는다.
바뀌는 건 가격과 구성이고, 판단 순서는 그대로다. 용량은 입장권이고, 대역폭은 들어간 뒤의 체감 성능이다.
참고 자료
- NVIDIA DGX Spark: 128GB LPDDR5x, 273GB/s 사양
- NVIDIA GeForce RTX 4090: 24GB GDDR6X 사양
- Apple Mac mini 기술 사양: M6 32GB 170GB/s, 통합 메모리 구조
- NVIDIA 기술 블로그: prefill은 연산, decode는 대역폭에 묶인다는 설명
- NVIDIA 블로그: DGX Spark 64GB 구성(10월 23일 파트너 판매)과 RTX Spark PC 10월 출시 언급
'IT > Data · AI' 카테고리의 다른 글
| LTX 뜻: AI 영상 모델 LTX-2.5 VRAM (0) | 2026.11.03 |
|---|---|
| agent 뜻, IT에서는 이런 의미로 쓰인다 (0) | 2026.10.15 |
| 추천 시스템 구조, 후보 생성과 랭킹은 왜 나눌까 (0) | 2026.10.04 |
| 추천 시스템 평가 지표, RMSE만 보면 속는 이유 (0) | 2026.10.04 |
| AI 에이전트 권한 설계, 오픈AI 사건으로 검증해봤다 (0) | 2026.09.30 |